Chromium进化论
TL;DR:Chromium 的架构是在需求、兼容性、性能和维护成本的变化中逐步形成的。本次分享选取五次技术选择,结合当时的文档和代码,观察团队为什么改变原有方案,以及改变之后又承担了什么成本。
Q:chromium跟进化论有什么共同点?
A:都可以用恐龙作为它们的代表性图标。
写在前面:为什么要看chromium的进化
Chromium不仅是一个 Web 应用运行平台,同时也是 Chrome、Edge、Electron、CEF 等众多浏览器和桌面应用的核心基础。
到底有多核心,看看这个神秘应用:https://github.com/ShirasawaSama/CefDetectorX
想写一个关于 chromium 整体架构的文章,但是写着写着就想: AI 时代了,想了解一个程序的架构,直接让 AI 读代码,有问题就问就好了,有必要还让人整理出来讲一讲吗?我问任何问题都很方便获取答案的今天,还可以分享什么东西?
突然想到, AI 现在经常被诟病 taste ,或者说“审美”方面的缺陷。而这些能力在技术选型中很重要,需要人来积累经验做出更优的决策。所以这篇文档就以“进化”为切入点,讲讲 chromium 为什么长成现在这个样子,它经历了哪些关键的技术判断。
为什么要有Chromium?(2006~2008)
旧浏览器,新趋势
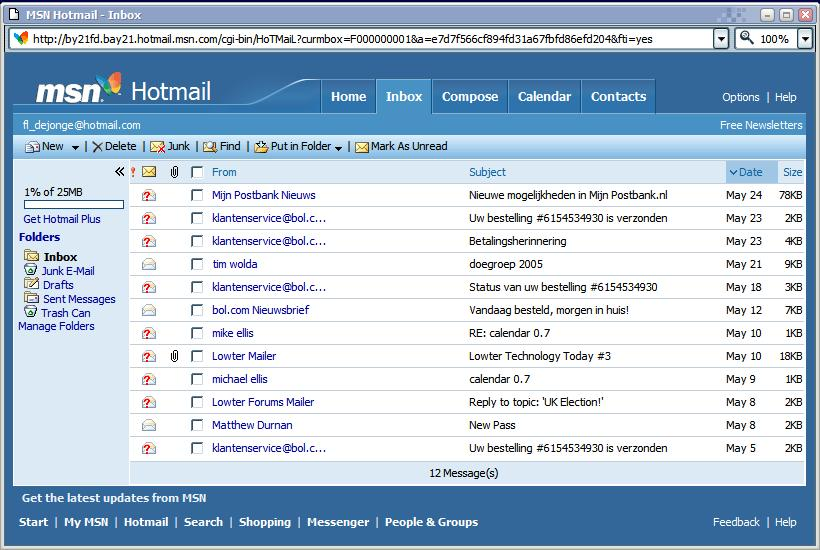
当时的大多数网页都是静态网页,也就是说,浏览器更多像是一个“阅读器”,阅读对应网址下的网页内容。
但随着前端开发的不断深入,网络已经从单纯的文本页面发展成了丰富且交互性强的应用程序,浏览器的性质正在发生改变。
2003—2006 年间,Web 正在发生剧烈变化。Alexa Top 100 首页中,平均 JavaScript 大小从 2003 年的约 15.3 KB 上升到 2006 年的 64.9 KB;超过 10 KB JS 的页面比例从 35% 增长到 71%。XHR 也突然普及:2003、2004 年 Top 100 首页几乎没有使用,2005 年只有 1 个,而 2006 年已经达到 28 个。作者拿地图应用做对比:传统地图站点平均约 32.3 KB 代码,而 Google Maps 等交互式地图站点平均约 296 KB,差不多一个数量级。
暴露的问题与解决方案
这些改变暴露了当时主流浏览器的一些明显的问题:
1 | |
| 问题 | 对用户的影响 | 架构需要提供什么 |
|---|---|---|
| 一个页面或插件出错,影响整个浏览器 | 邮箱崩溃,其他正在工作的页面也丢失 | 故障隔离 |
| 一个应用持续占用执行资源 | 页面、标签切换或浏览器界面失去响应 | 独立调度与终止能力 |
| 不可信网页触发原生代码漏洞 | 攻击可能获得用户的系统权限 | 权限隔离 |
| JavaScript 应用越来越复杂 | 应用开发者能实现的功能受到性能限制 | 更强的执行引擎 |
总而言之,既然网页越来越像“应用”,那它跟桌面应用比到底有哪些问题?桌面应用有操作系统的进程隔离的支持,不同的应用之间不会互相影响,同时执行效率也大大高于web应用。
怎么解决web应用的这个大劣势呢?那就是直接复用操作系统层面提供的进程隔离能力,让不同的web应用也分立不同的进程,这也是chromium最核心的架构——多进程架构。
进程是一个运行中的程序实例,拥有自己的虚拟地址空间和操作系统资源,实际执行代码的是其中的线程。操作系统配合硬件内存保护,让普通代码不能用一个指针随意读写另一个进程的私有内存。因此,一个进程发生越界访问或崩溃时,通常可以单独终止它,其他进程仍能继续运行。
多进程架构
既然多进程架构可以解决这么多问题,那到底应该怎么设计多进程的架构呢?chromium把进程分成了这3种:
- Browser: 浏览器进程(主进程),可以调度子进程,负责UI,网络等能力,可以和操作系统进行直接交互。
- Renderer:渲染器进程(子进程),负责渲染页面。一个renderer进程对应浏览器中的一个或几个标签页,通过安全沙箱严格防止renderer进程直接调用底层能力。如果需要调用底层能力需要通过ipc(进程间通信)让browser进程帮忙。
- Plugin:插件进程,负责flash等其他功能。
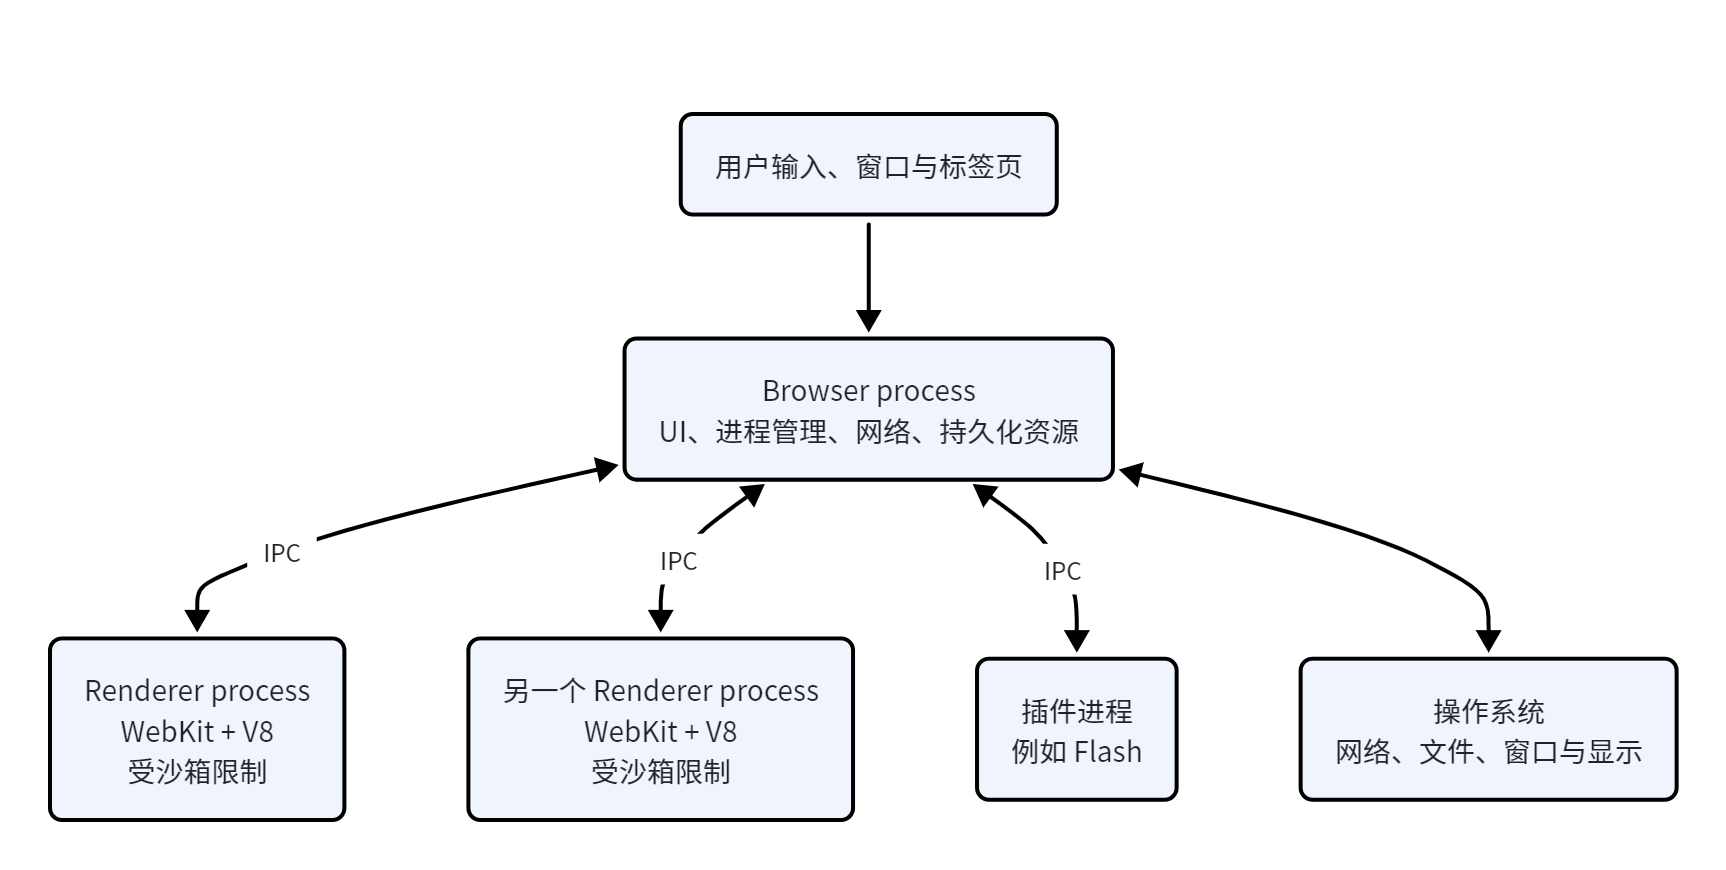
其中,在renderer子进程的拆分中,也需要为了平衡性能和安全做一定的妥协:多进程可以保证一定的基本的安全性,但是肯定是伴随着性能的开销。考虑到复用缓存,当时的 chromium 以 Site 为基本的进程划分的单位。总的来说,Chromium 不是按 UI 元素划进程,而是按“需要共享执行语义”和“需要相互隔离”的边界划进程。
进程和标签页是否一直是1对n的形式呢?也不一定。在后续的演进中,考虑到安全问题,将标签页上的iframe也作为独立进程。
产品还是内核?(2010~2012)
焦油坑初见端倪
多进程解决了网页之间的故障与权限隔离,但没有自动解决代码之间的耦合。随着自动填充、密码管理、扩展等功能增长,通用的网页运行机制和 Chrome 的产品行为开始纠缠在一起。
当时增加 Autofill 这样的功能,经常需要同时修改 renderer 侧的 RenderView、browser 侧的 RenderViewHost、页面对象及公共 IPC 消息文件。每个功能都往同一批核心类里加代码,核心类就越来越难理解和修改。官方文档也承认:功能接入了不合适的位置,接口和功能混在一起,开发者难以判断新代码应该放在哪里。
这个时候的 chrome 可能像是进入了焦油坑的公牛一样,需要进行架构上的调整。同时也需要对这个项目到底是一个开源浏览器产品,还是一个通用web应用执行引擎做出回答。
Content & Component
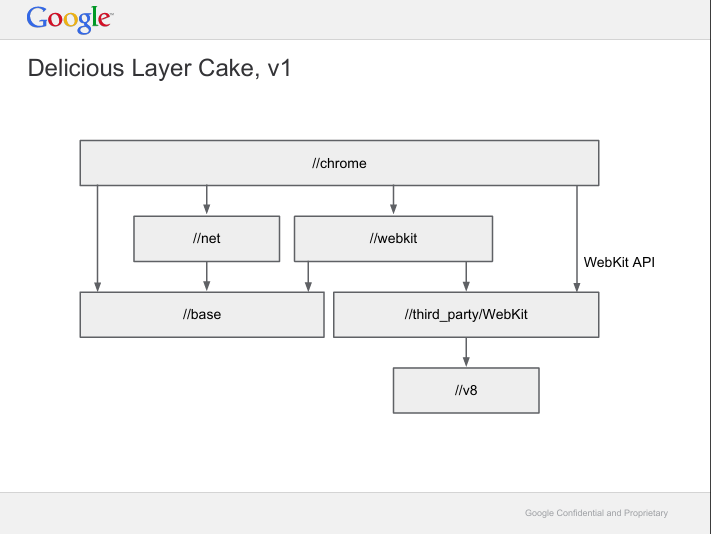
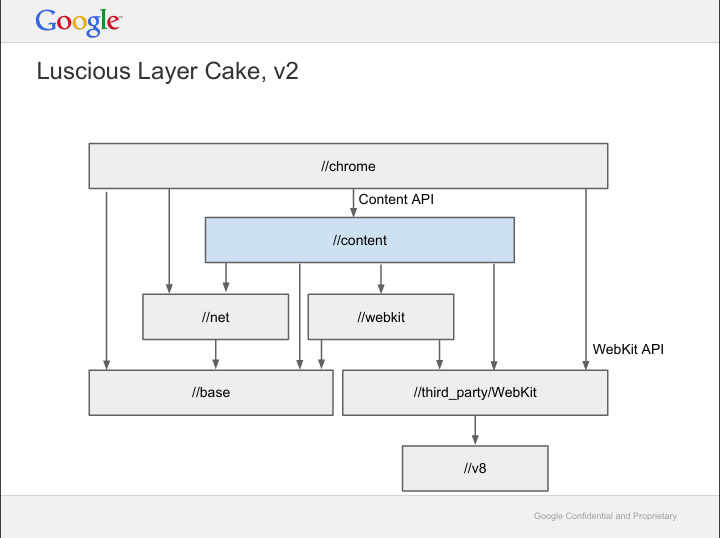
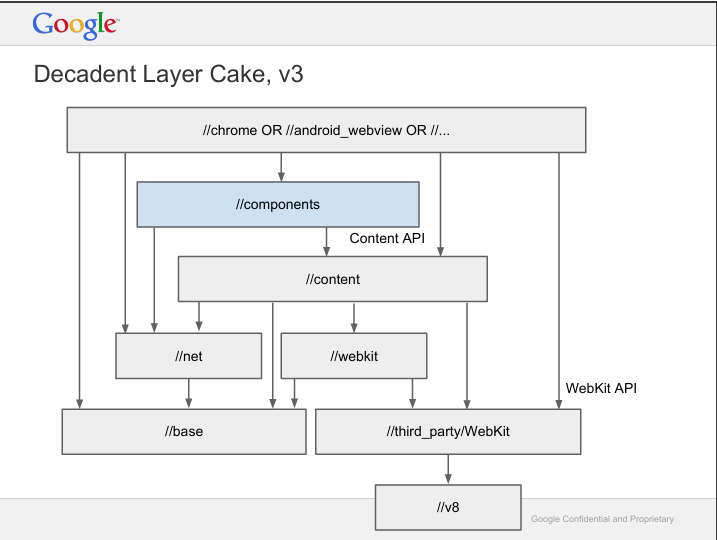
第一次拆分:让网页运行核心能够脱离 Chrome 产品使用,明确把多进程核心代码迁入 src/content。它逐渐承接导航、页面与 frame 生命周期、进程管理等机制,并通过 Content API 与宿主交互。Chrome 则保留产品界面、功能组装和策略。
一个很具体的边界是 BrowserContext:
1 | |
WebContents 只需要知道网页所处的浏览上下文;Chrome 的 Profile 再在这个基础上组织书签、密码、同步等产品服务。这样,核心代码可以面向 BrowserContext 工作,另一个宿主提供自己的上下文实现,而不必为了运行网页同时接受 Chrome 的整个 Profile。
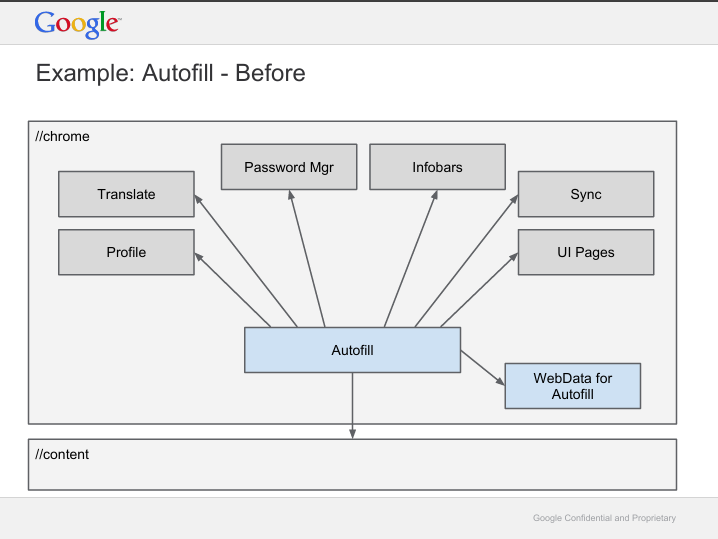
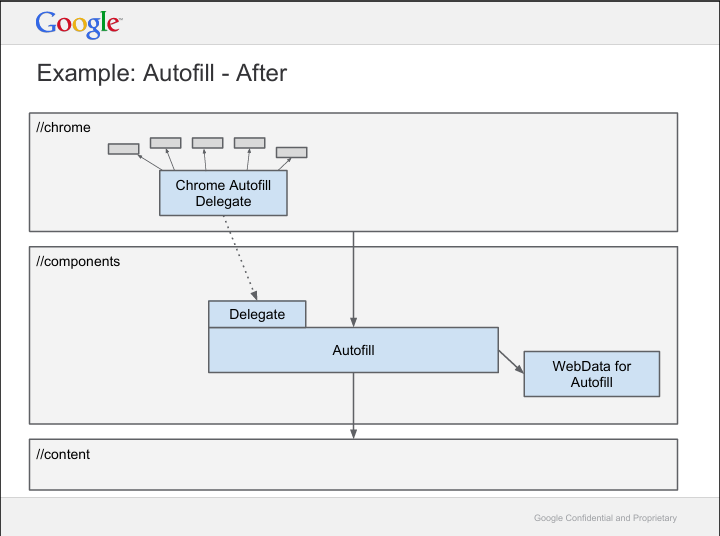
第二次拆分:让浏览器功能也能被其他产品选择性复用。有了 Content,其他产品能运行网页,却不会自动获得 Chrome 的自动填充等功能。Android WebView 等产品需要复用其中一部分,于是团队继续将共享功能从 chrome 提取到 components,产品自身负责创建、配置和接入这些组件。
以 Autofill 为例:过去实现有大量的直接依赖。组件化后,共享逻辑通过自己定义的接口请求能力,Chrome 的集成代码负责实现接口。需要读取设置,就传入所需的设置服务,而不是把整个 Profile 交给组件。依赖没有凭空消失,而是被集中到较小的产品集成代码中。
影响和结论
Content 为嵌入 Chromium 提供了重要边界。CEF 在 2008 年就已存在,Content 在 2011 年末逐渐可用后,CEF 才转向这条路线,并在 2013 年初发布支持多进程的 CEF3。Electron 则在 Chromium 基础上继续完成 Node.js、原生窗口、应用生命周期及 JavaScript API 的集成。
因此,这段演进包含两项不同的收益:Content 让网页运行核心可以复用;Components 让浏览器功能可以按需复用。框架再把这些能力组织成应用开发者能使用的接口。边界也有成本:宿主仍需维护集成与版本适配,CEF 后来为获得更多完整浏览器功能,又发展了 Chrome runtime。
在现在的代码仓库中,Chrome文件夹中的内容是chromium浏览器的业务代码,可以通过这里的代码构建出chromium浏览器。如果要开发chromium内核的其他项目,开一个新的文件夹就可以了。
Web 平台:复用还是自研?(2008~2013)
什么是 web 平台
网页内容的解析、样式计算和布局主要发生在 renderer 进程中,最终像素生成与显示还需要图形、合成等模块协作。那么,浏览器如何把请求得到的 HTML、CSS、JavaScript 和其他资源,变成我们能看到、能交互的 Web 应用?这涉及浏览器对 Web 平台的一整套实现。
以一个点击后修改文字的按钮为例:
1 | |
web平台都需要完成下面这些工作:
- 解析 HTML,建立 DOM。HTML 文本变成内存里的文档对象树:按钮是一个元素,它包含一个内容为“你好”的文本节点。DOM 同时提供访问和修改这些对象的接口。
- 计算样式。解析 CSS、匹配选择器,并处理继承、优先级和默认样式,确定按钮文字的颜色、字号等最终属性。
- 执行脚本,持续更新页面。点击事件触发回调,由 JavaScript 引擎执行代码;对 textContent 的赋值通过绑定层进入 DOM 实现,修改按钮的文本节点。浏览器随后按需更新布局与画面,并尽量合并修改、复用未失效的结果。
为什么一开始用 webkit
- 轻量:多进程意味着会同时运行多份引擎实例,单个实例的开销很重要。
- 容易改造:为了沙箱隔离,需要把引擎对本地文件系统、原生窗口系统等能力的直接访问剥离或接管。
- 开源且已有实践:Chromium 需要开源;Android 团队已经使用 WebKit,并推荐它的速度、灵活性和相对容易理解的代码。Chrome 团队还搭建了多进程测试程序验证可行性。
这一阶段的选择可以概括为:把成熟的网页兼容性基础接进新的浏览器架构,让团队有能力集中解决进程隔离、响应性和脚本性能问题。
blink
2013 年,Chromium 团队宣布从 WebKit 分叉出 Blink。这里的变化是继承已有网页引擎代码、建立独立演进的分支。
早期复用 WebKit 的收益很大,但随着项目发展,共享代码需要兼顾不同产品的架构。一个具体分歧是多进程能力放在哪一层:WebKit2 把进程管理封装在自己的嵌入 API 之内,应用使用网页视图时就能获得多进程能力;Chromium 则在所使用的 WebKit API 之外,通过自己的架构管理进程、通信与沙箱。双方都支持多进程,但边界不同。
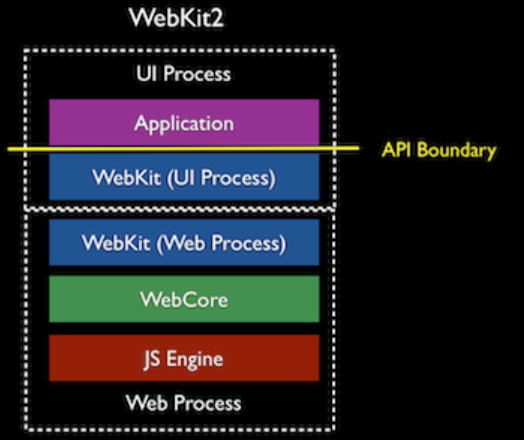
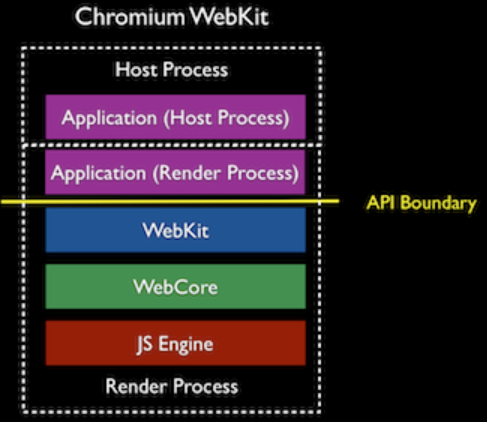
官方给出的分叉理由是:同时支持这些不同架构,逐渐增加了 WebKit 和 Chromium 双方的复杂度,拖慢了演进。独立维护 Blink 后,团队可以清理自身不再需要的配置,并围绕 Chromium 的需求调整接口和内部结构,包括简化与 V8 的绑定、提高并行度、支持跨进程 iframe。
1 | |
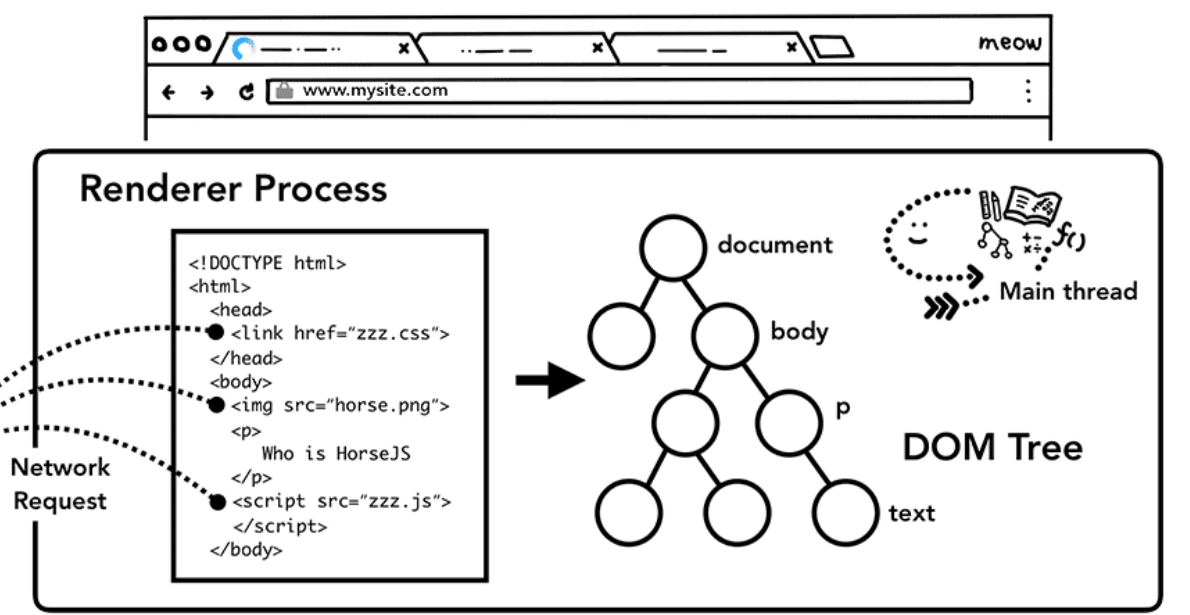
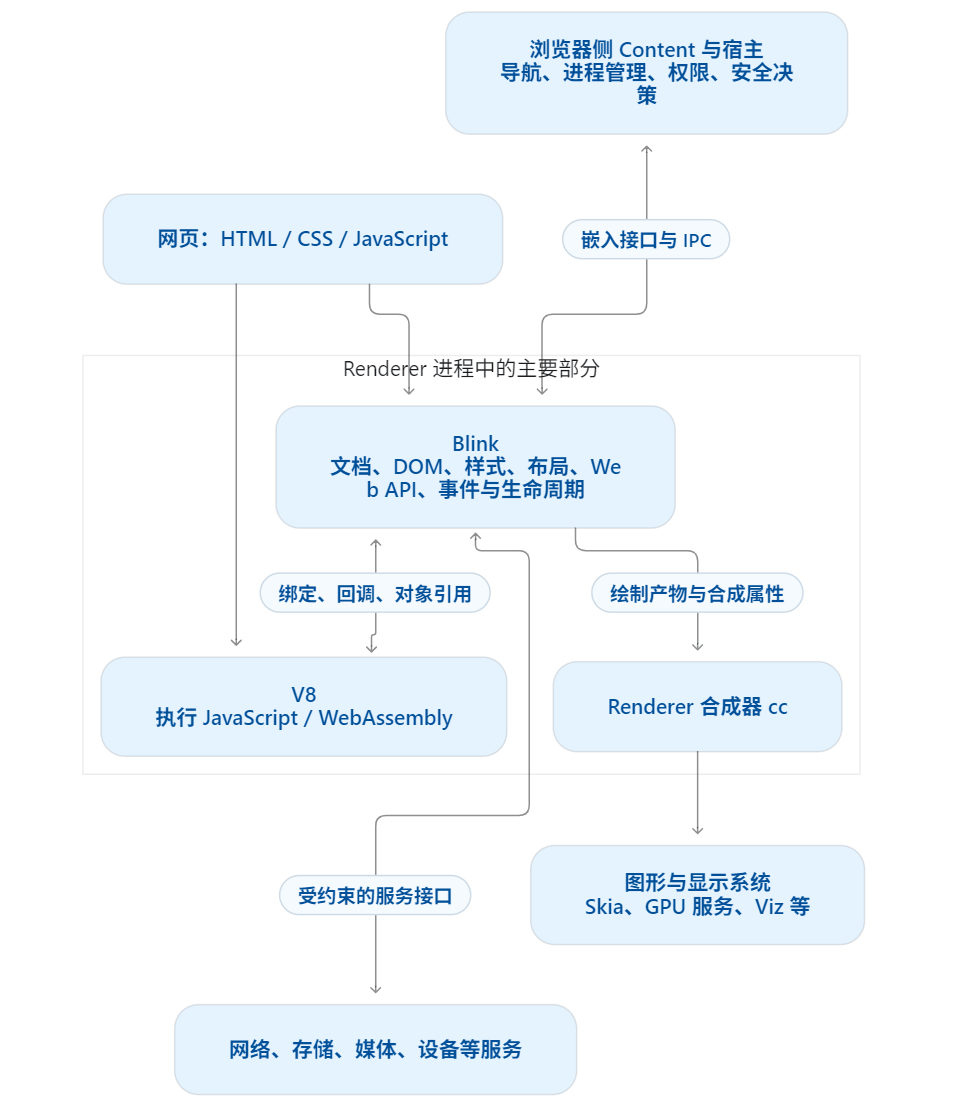
具体来说,blink 通过这样的步骤来渲染出一个 web 页面:
- html会变成真正的 C++ 对象。它经过blink的语法解析器进行解析,解析出真正的 DOM 树。html 有自身的标准,并且在 web 应用运行的过程中,html 有可能会因为 JS 代码对网页的操作而改变,这里需要 blink 来控制刷新等功能。
- V8 通过绑定代码操作这些 DOM 对象。blink 的 web IDL文件声明相关绑定,构建时,IDL 编译器生成绑定代码,负责把 JavaScript 属性访问接到 C++ 实现上,包括接收者检查、类型转换、返回值转换等。JavaScript 中拿到的 DOM 对象,是连接 Blink 对象的包装对象。
- 解析 CSS ,完成选择器匹配、层叠、继承等过程,计算出每一个元素的具体样式。
- 通过 CSS 计算完样式仍然是不够的,因为元素真正的大小它还是收到布局,窗口等影响。这里chromium会使用 LayoutNG 来计算真正的大小。
- 进入 Pre-paint 阶段,会更新绘制所需的属性关系,并判断哪些内容失效。属性包括
Transform,Clip,Effect, 和Scroll。 - 最后在底层通过调用cc, skia, dawn, angle, viz等图形学组件来绘制页面。
网络如何解耦成一种“服务”?(2013~2020)
网络曾经的困境
chromium 的很长一段时间,网络的相关基础能力都实现在 Browser 进程,这是很合理的。但是几个问题驱使谷歌讲网络能力迁移到独立的进程:
- 网络栈崩溃,不应该导致整个浏览器退出。
- 处理不可信网络数据的代码,不应天然拥有 Browser 的全部权限。
- renderer实际上也会大量调用网络功能,希望网络能力能服务于不同的调用方和运行环境。
但是具体怎么迁移?迁移之后网络的形态是怎样的?这里就有几个问题需要解决。
进程间通信问题:Mojo
Chromium 原来的 IPC::Channel 系统能通信,但接口往往围绕 Browser 与子进程的既有关系组织。每个 Content 子进程与 Browser 之间通过一条通道传递消息。
1 | |
这行代码依赖的不只是“发一个请求”,还有既有的消息通道、目标对象的路由和请求跟踪机制。当网络实现要从 Browser 移出去时,就需要重新安排这些连接关系。
而 Mojo 将通信围绕“接口端点”组织。开发者用 .mojom 文件声明接口、方法、参数和响应,工具生成绑定代码。调用方持有 Remote,接收方用 Receiver 把另一端绑定到实现;双方通过消息管道通信,既可以在同一进程,也可以跨进程。调用者依赖“某个能力的接口”,实现的位置主要由连接和启动代码决定。
mojo是服务化的一种基础设施,它本质上就是一个进程间的 rpc,把进程间通信这件复杂的,需要标定特定进程的事情改造成了“具体进程无关”的能力,再之后服务化改造的时候就不需要考虑调用具体来自哪个进程了。
Network Service
network service 是 chromium 将网络相关功能解耦出来,得到的一个服务。这个服务可以为任意进程提供网络相关能力,并且性能更高;同时,依赖项也变得更加清晰,方便单独测试。它把 HTTP、HTTPS、TCP、QUIC、DNS、Cookie、网络缓存等底层网络能力封装起来,通过 Mojo 接口提供给 Browser、Renderer 等其他组件使用。
V8:什么时候值得为代码付出编译成本?(2008~ - )
自研一个 JS 运行时
前面提到,web 应用需要处理越来越复杂的业务逻辑,JavaScript 的执行效率逐渐成为应用体验的瓶颈。2006 年秋天,Google 招募 Lars Bak 为当时尚未公开的 Chrome 开发新引擎;2008 年 9 月,V8 随 Chrome 一同开源。团队希望把动态语言虚拟机领域已有的经验带到浏览器,让 JS 能承担更复杂的应用。
| 浏览器 | 当时的 JavaScript 引擎 |
|---|---|
| Internet Explorer 7 | Microsoft JScript |
| Firefox | SpiderMonkey |
| Safari | JavaScriptCore(随后发展出 SquirrelFish 等实现) |
V8 的范围是什么?它应该只服务于 Chrome 浏览器,还是作为通用的 JS 引擎,供其他程序嵌入?Google 从早期就为后者留出了接口,2009 年出现的 Node.js 是一个重要例子。2011 年,V8 又引入了 Isolate,使一个进程可以容纳多个相互分离的 V8 实例。需要区分:V8 负责语言执行,DOM、网络、事件循环等能力由浏览器或 Node.js 这样的宿主提供;Isolate 也不等于操作系统进程沙箱。
编译器还是解释器?
编译器(Compiler)和解释器(Interpreter)的区别是「如何执行代码」,而 AOT(Ahead-of-Time)和 JIT(Just-in-Time)的区别是「什么时候编译代码」。
2008 年的 V8 会把即将执行的 JS 编译成机器码,再交给 CPU 执行。它属于 JIT:编译发生在程序运行期间。后来引入解释器,也没有改变 V8 同时包含编译器和运行时的性质。
早期 V8 的一个重要设计是隐含类(Hidden Class,源码中称为 Map)。JavaScript 对象的属性可以动态变化,V8 则在运行时记录它们的结构:哪些属性存在、对应什么布局。内联缓存(Inline Cache)记住某个访问点遇到过的结构和访问方式,使常见的属性读取可以变成“检查结构,再按固定偏移读取”。这并不是给 JS 加上静态类型,也不是在编译时就能确定所有对象布局。
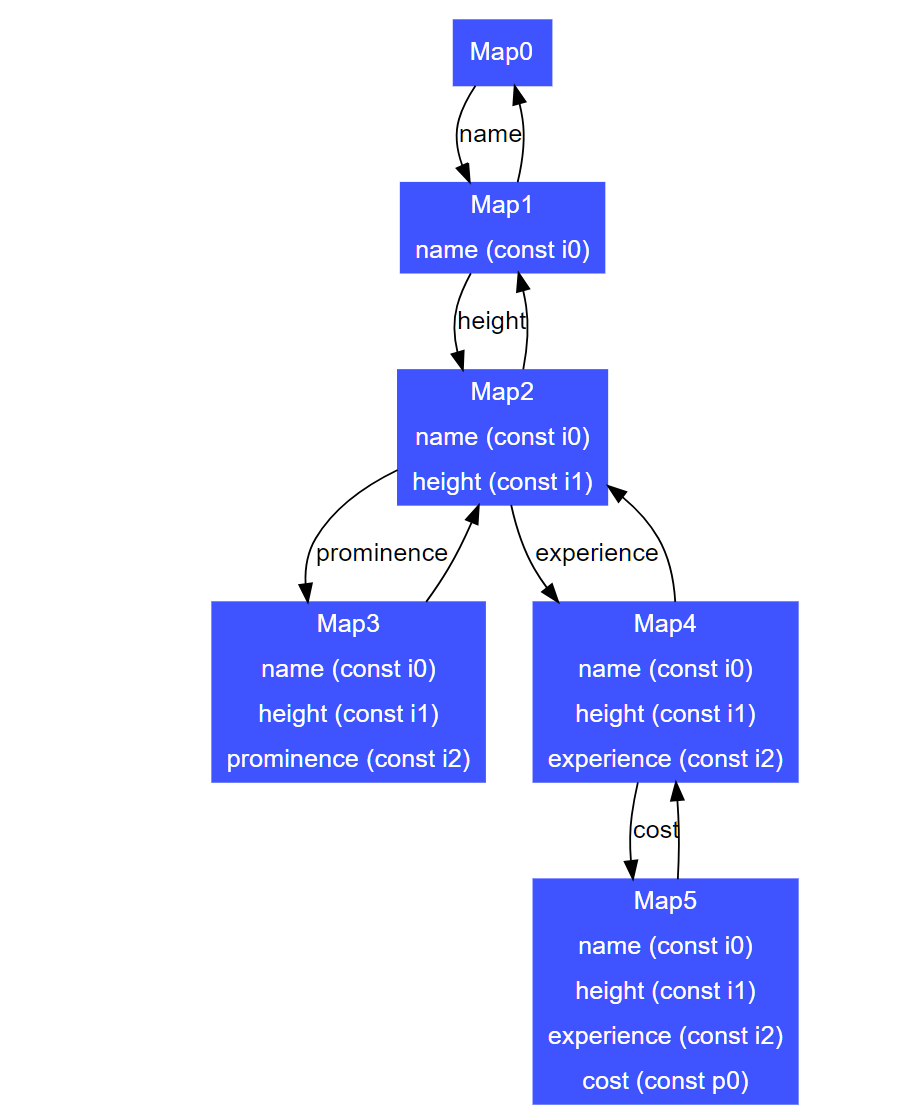
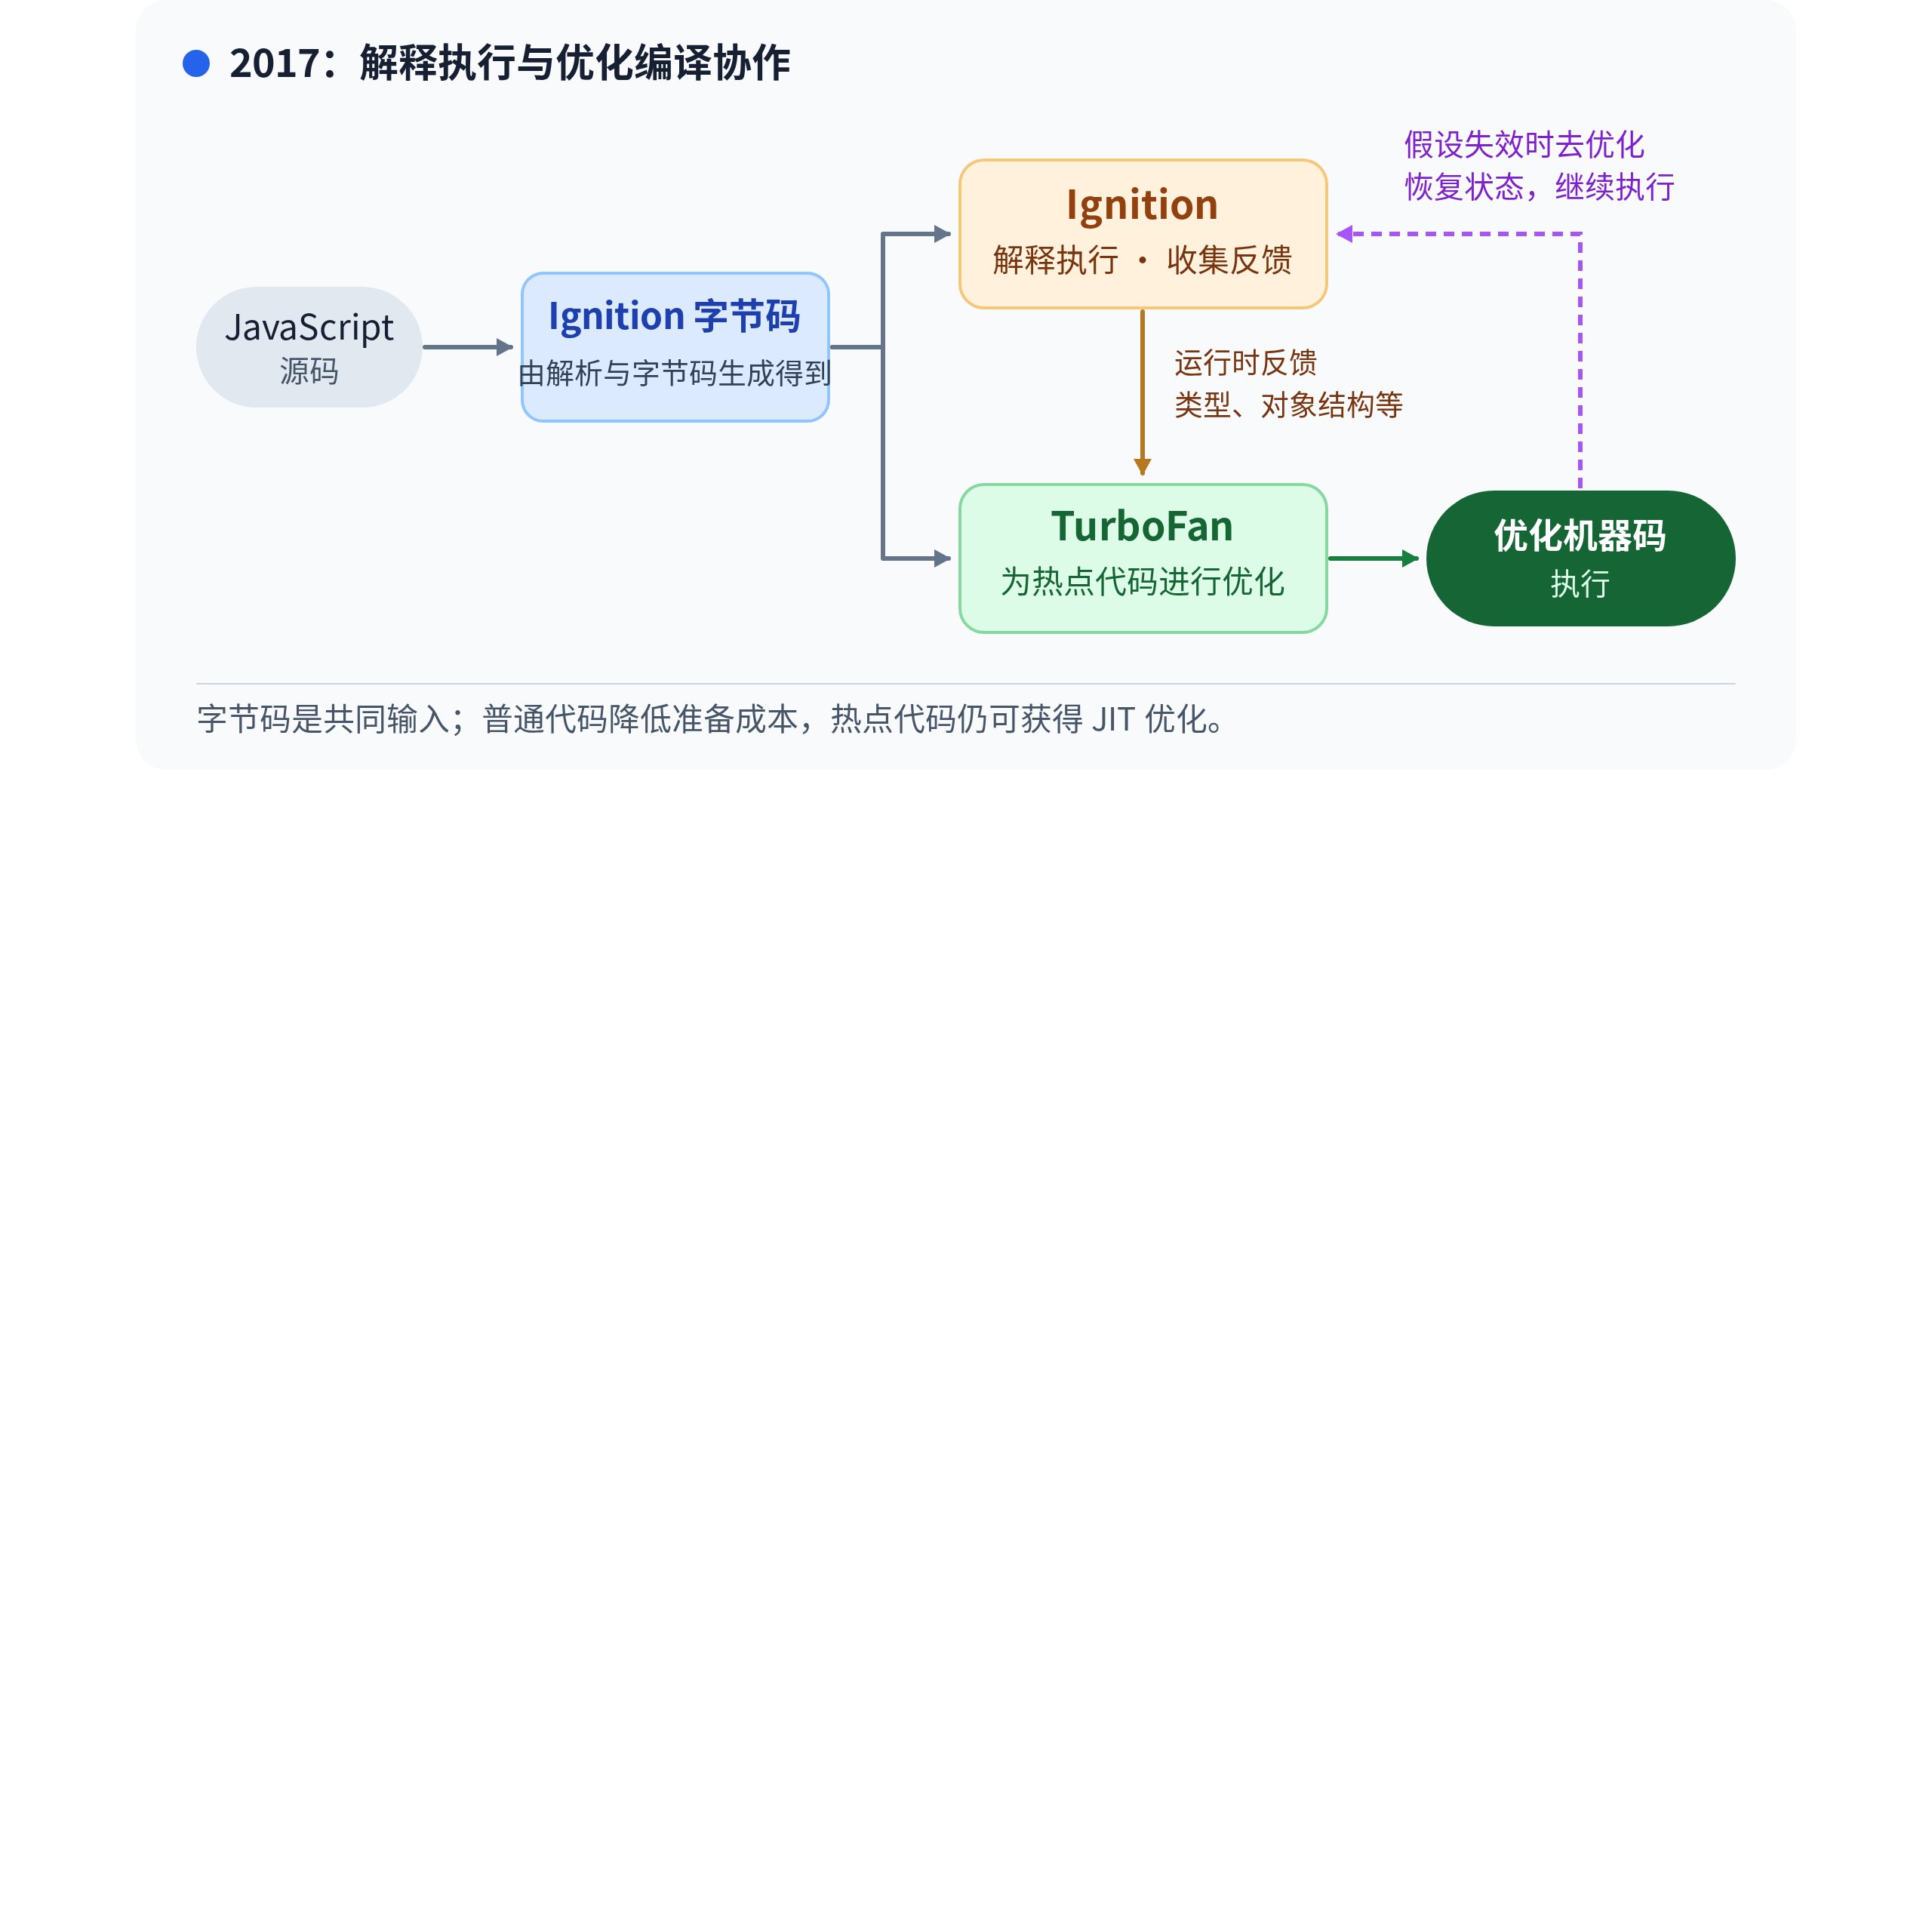
2010 年,Crankshaft 在这个基础上增加了热点优化。Full-codegen 先快速生成基线机器码,程序在执行时收集类型、对象结构等反馈,Crankshaft 再据此优化热点函数。比如 a + b 一直遇到整数,就有机会走专门的整数路径;如果后来出现字符串,运行时检查会触发去优化(deopt),恢复较低执行层需要的状态,从对应位置继续执行,而不是从函数开头重跑。
但旧优化器逐渐难以扩展:try/catch/finally 等结构难以进入优化路径,新特性又经常需要为多种 CPU 编写平台相关代码。2013 年启动的 TurboFan 因此把高层语义优化、底层优化和指令选择分开,逐步接替 Crankshaft。它解决的是优化器的扩展和维护问题。
随着网站代码越来越多、移动设备变得重要,问题逐渐突出:一段代码最终执行得多快,只是总成本的一部分;解析、编译、保存它,也都要付钱。
为大量只执行一两次的初始化代码生成机器码,未必划算。V8 于 2015 年开始开发 Ignition,2016 年先在部分低内存 Android 设备上启用,2017 年随 Chrome 59 / V8 5.9 切换到 Ignition + TurboFan:普通代码先以紧凑的字节码解释执行,值得优化的热点代码仍然由 JIT 编译。
分层编译:为多快的代码付出多少成本?
两层之间仍有空隙:有些函数已经值得摆脱解释器的解码和分派开销,却不足以收回 TurboFan 的编译成本。2021 年的 Sparkplug 因此直接从字节码快速生成机器码,不构建复杂的优化 IR。
2023年, Chrome 引入 Maglev,填补 Sparkplug 与 TurboFan 之间的另一段空隙:利用运行反馈做类型特化等优化,但减少分析遍数,尽快产出较好的代码。例如读取 o.x 时,如果反馈指向一种对象结构,就可以在建图时直接生成下面的检查和字段读取。
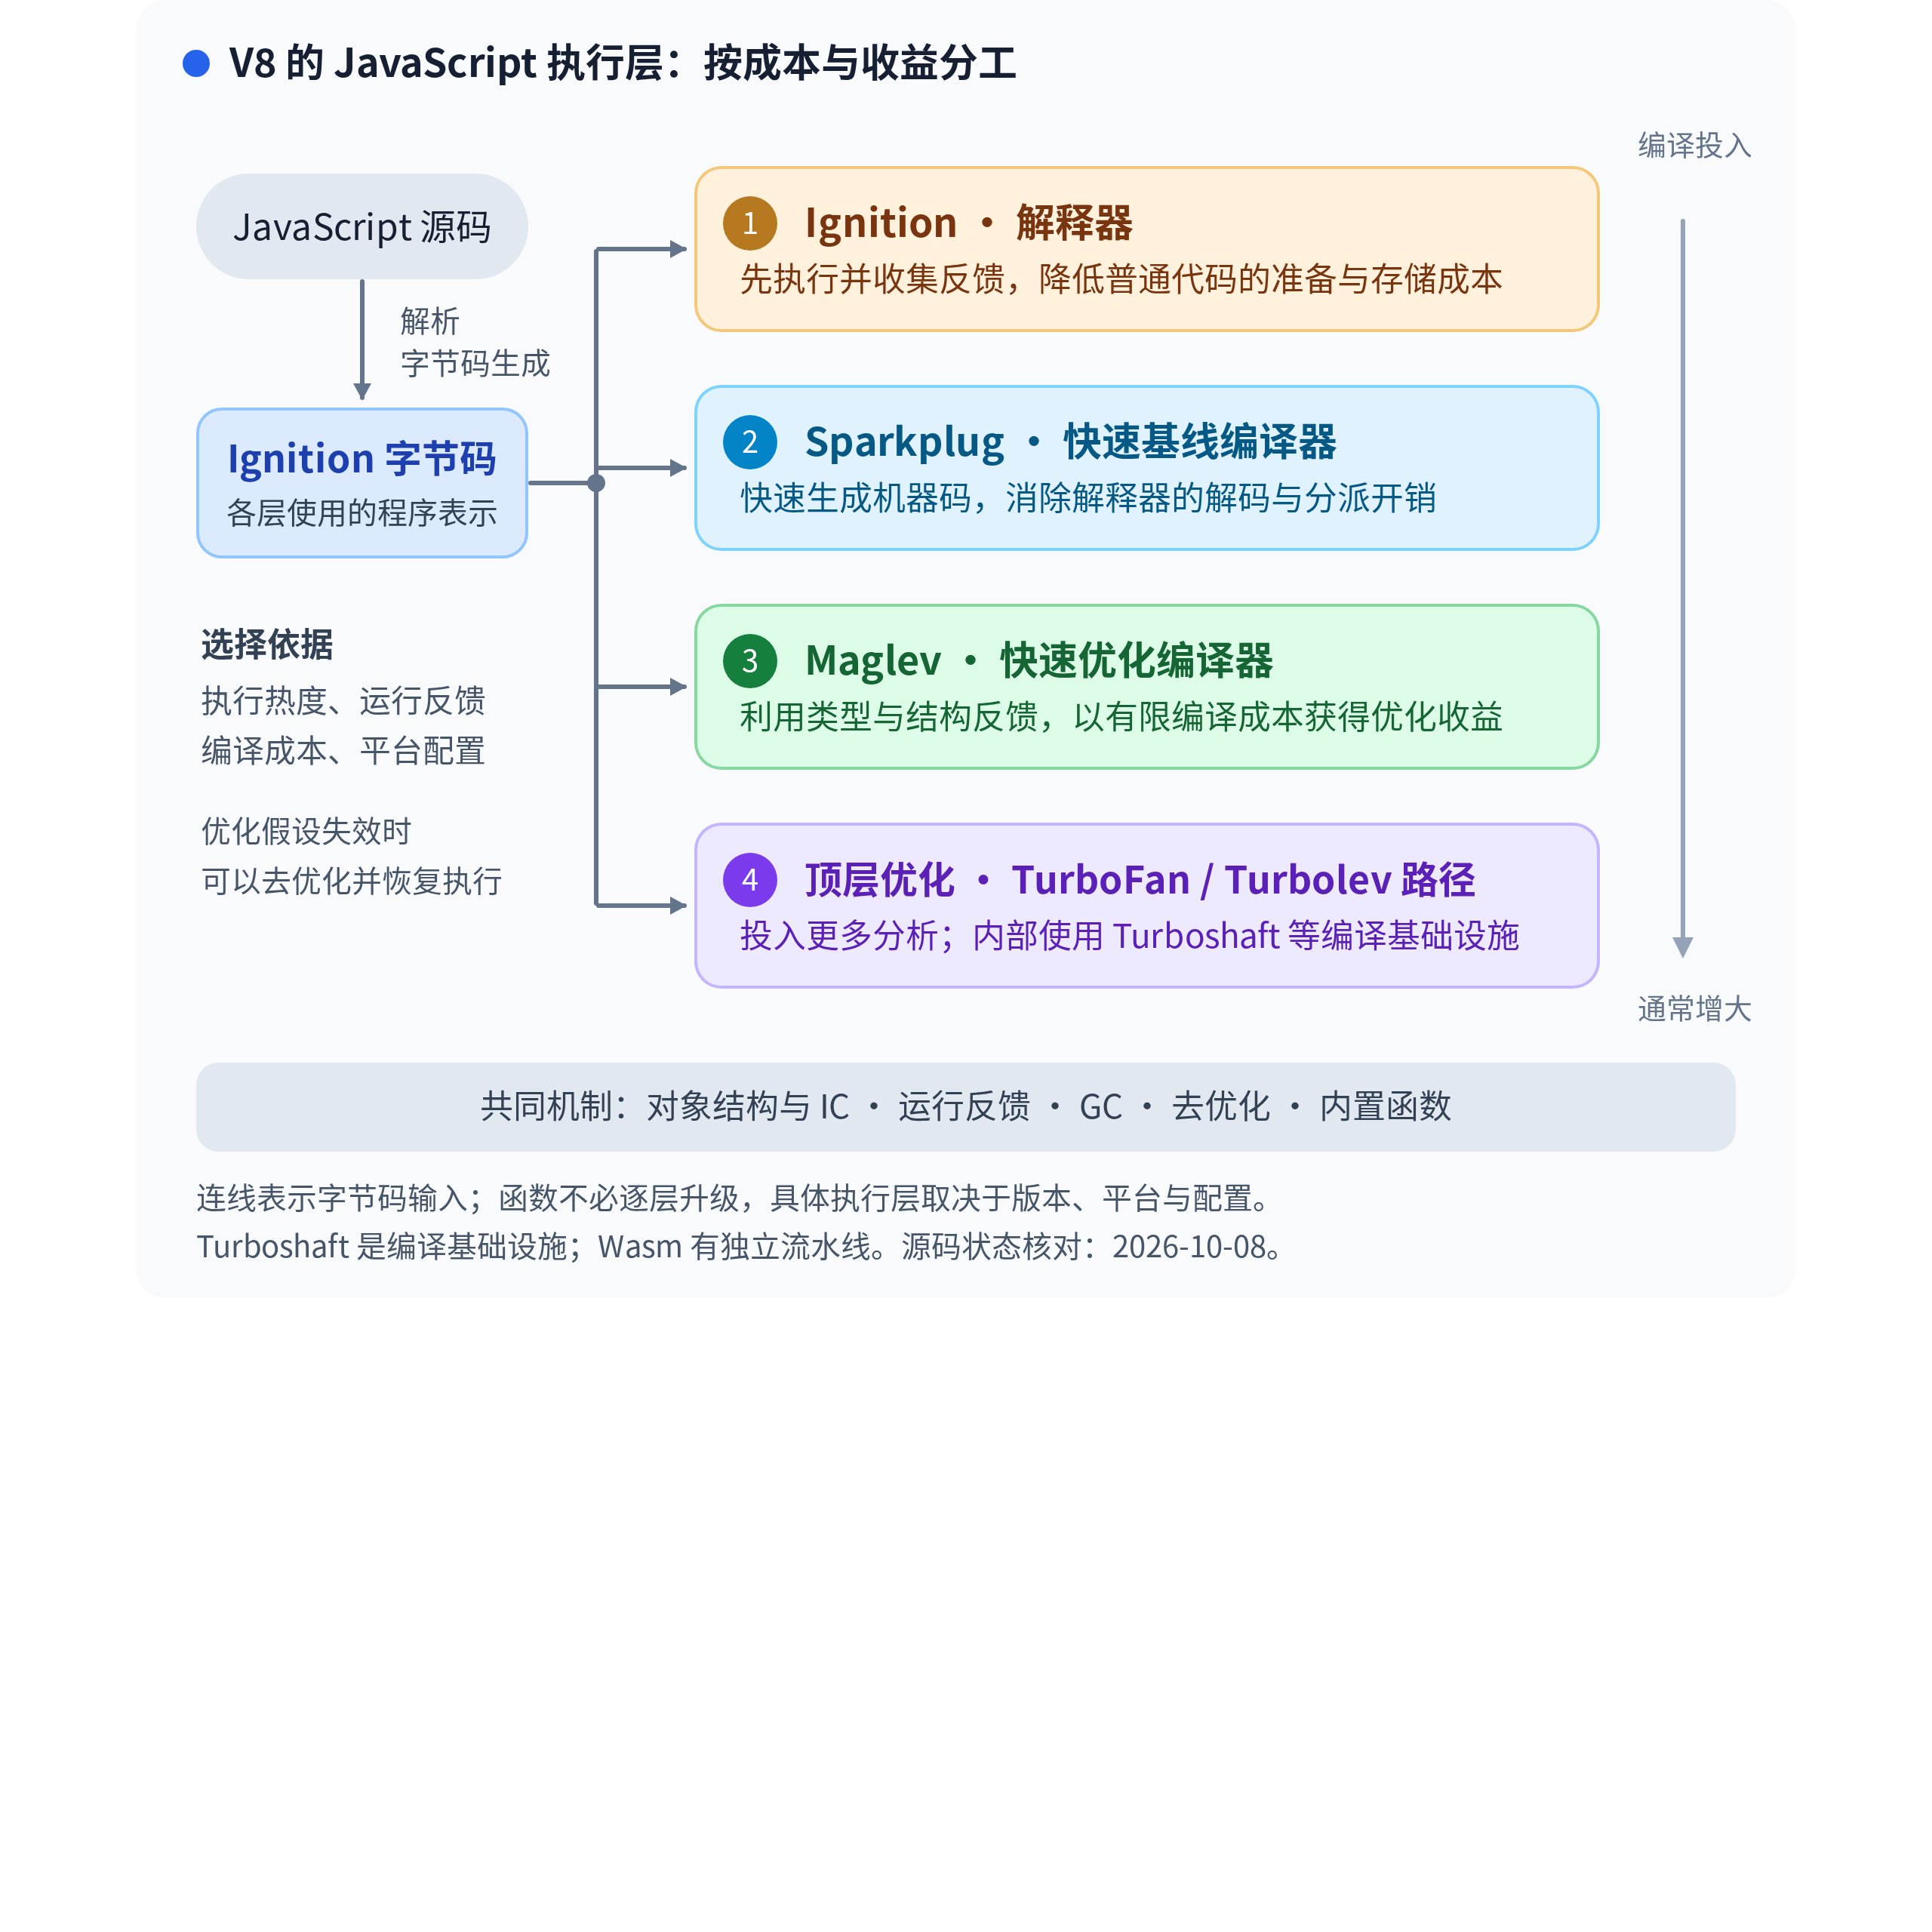
V8 还包含对象模型、垃圾回收、内置函数、嵌入接口和安全机制;WebAssembly 则有以 Liftoff 为基线编译器的独立流水线。分层也不是免费午餐:新增层次需要更多切换与维护逻辑,只有当省下的执行时间能覆盖编译和内存成本时,才值得启用。
Refs
- https://googleblog.blogspot.com/2008/09/fresh-take-on-browser.html
- https://googleblog.blogspot.com/2009/05/2008-founders-letter.html
- https://charlesreis.com/research/publications/UW-CSE-07-12-01.pdf
- https://www.adambarth.com/papers/2008/barth-jackson-reis.pdf
- https://blog.chromium.org/2008/09/multi-process-architecture.html
- https://static.googleusercontent.com/media/research.google.com/en//pubs/archive/34924.pdf
- https://www.chromium.org/developers/design-documents/multi-process-architecture/how-to-add-new-features/
- https://github.com/chromium/chromium/blob/main/content/README.md
- https://blog.chromium.org/2008/09/chrome-3s-webkit.html
- https://trac.webkit.org/wiki/WebKit2
- https://github.com/chromium/chromium/blob/main/docs/mojo_ipc_conversion.md
- https://docs.google.com/document/d/1wAHLw9h7gGuqJNCgG1mP1BmLtCGfZ2pys-PdZQ1vg7M/edit?tab=t.0
- https://v8.dev/blog/maglev
- https://whisper3zzz.top/posts/cross-language-call